2026年10月16日、AWSの公式ブログに、同社の自律型ペネトレーションテストエージェント「AWS Security Agent(now part of AWS Continuum)」が、最近公開された実在のCVE(脆弱性)37件のうち33件のエクスプロイト(脆弱性を突く攻撃)に成功したという記事を公開しました(英語の原文は2026年10月15日公開)。「何が発表され、37件中33件とはどういう意味で、自分たちに関係あるのか」を、AWSの発表に書かれた内容だけをもとにやさしく整理します。
【結論】この発表の要点は次の3つです。
- 何が: AIのペネトレーションテスト(擬似的な攻撃で弱点を探す検査)エージェントが、わずかなヒントだけで実在の脆弱性を自力で突いてみせた、という社内ベンチマークの結果です。
- いくつ中いくつ: CVE 37件のうち35件でフラグ(目印)を取得し、うち33件(89.2%)が「意図された脆弱性を正しく突いた本物の成功」と監査で確認されました。
- 読者にとっての意味: これはAWS自身の発表で第三者検証ではなく、ベンチマークもAWS独自・サンプルは37件と小規模です。数字そのものより「攻撃を自動化するAIがここまで進んでいる」という流れを押さえるのが実用的です。
先に用語だけ:この記事に出てくる言葉の最短解説
出てくる言葉を短く確認します。細かく覚える必要はありません。
| 言葉 | 最短の意味 |
|---|---|
| CVE | ソフトウェアの脆弱性(弱点)につける世界共通の管理番号。米国政府の支援を受けた非営利団体MITREが採番します(IPAの解説より)。「CVE-西暦-連番」の形で1件の弱点に1つ付きます。 |
| ペネトレーションテスト | 攻撃者の視点で実際に侵入を試み、弱点がどこまで悪用できるかを確かめる検査。「侵入試験」「侵入テスト」とも(日本でも2024年4月に国の審査登録制度の対象に追加/経済産業省)。 |
| AIエージェント | 人が目標を決めると、最適な行動をAI自身が選んで自律的に実行するソフトウェア(AWSの用語解説より)。今回は「脆弱性を見つけて突く」役割を担います。 |
| AWS Continuum / AWS Security Agent | AWSのセキュリティ向けサービス。オンデマンドのペネトレーションテストなどを行うエージェントで、従来の「AWS Security Agent」がAWS Continuumの一部になりました。 |
| CTF形式のベンチマーク | 隠された「フラグ(目印の文字列)」を脆弱性を突いて取り出せたら成功、という形式の評価。CTF(Capture The Flag)はセキュリティ技術を競う競技です。 |
| コンタミネーション | 直訳は「汚染」。脆弱性の答え(解説記事やPoC)がAIの学習データに混入し、「実力で解いた」のか「答えを覚えていただけ」なのか区別できなくなる問題です。 |
ペネトレーションテストをもう少し知りたい方は、ホワイトハッカーとは?仕事内容と脆弱性診断(ペネトレーションテスト)の解説もどうぞ。
何が発表された? 検証の「条件」がポイント
AWSは、このエージェントを最近公開された実在のCVE 37件に適用しました。各CVEは、脆弱性の到達点(意図されたシンク)にフラグを隠した、稼働中のコンテナ化ターゲットとして用意されています。大事なのは、エージェントに与えられた条件が非常に限られていることです。
- 認証なし、または低権限から開始:ログイン済みの有利な状態ではなく、外部の攻撃者に近い立場からです。
- 与えられるのはエンドポイントURLと1行のヒントのみ:エクスプロイトやPoC(概念実証)は渡されません。
- 自力で一通りやる:脆弱性を発見し、動作するエクスプロイトを構築し、必要に応じてプリミティブ(攻撃の部品)を連鎖させてフラグを抽出します。
- 1サンプルあたり10時間の制限・Claude Opus 5上で実行:各課題の制限時間は10時間、AIモデルはClaude Opus 5です。
対象となるソフトウェアは、実際のサービスが動かしているものと同種です(Webフレームワーク、コンテナレジストリ、機械学習・AIプラットフォーム、Eコマーススタック、tRPC API、メディアプラットフォーム、LDAP管理コンソールなど)。今回のサンプルは2025〜2026年のCVE 37件で、設定ミスを見つけるだけでは解けず実際のエクスプロイトを必要とするものが選ばれています。
検証は7つのステージで進む
すべてのCVEは同じ固定パイプライン(決まった処理の流れ)で実行されます。その7つのステージを図にまとめました。
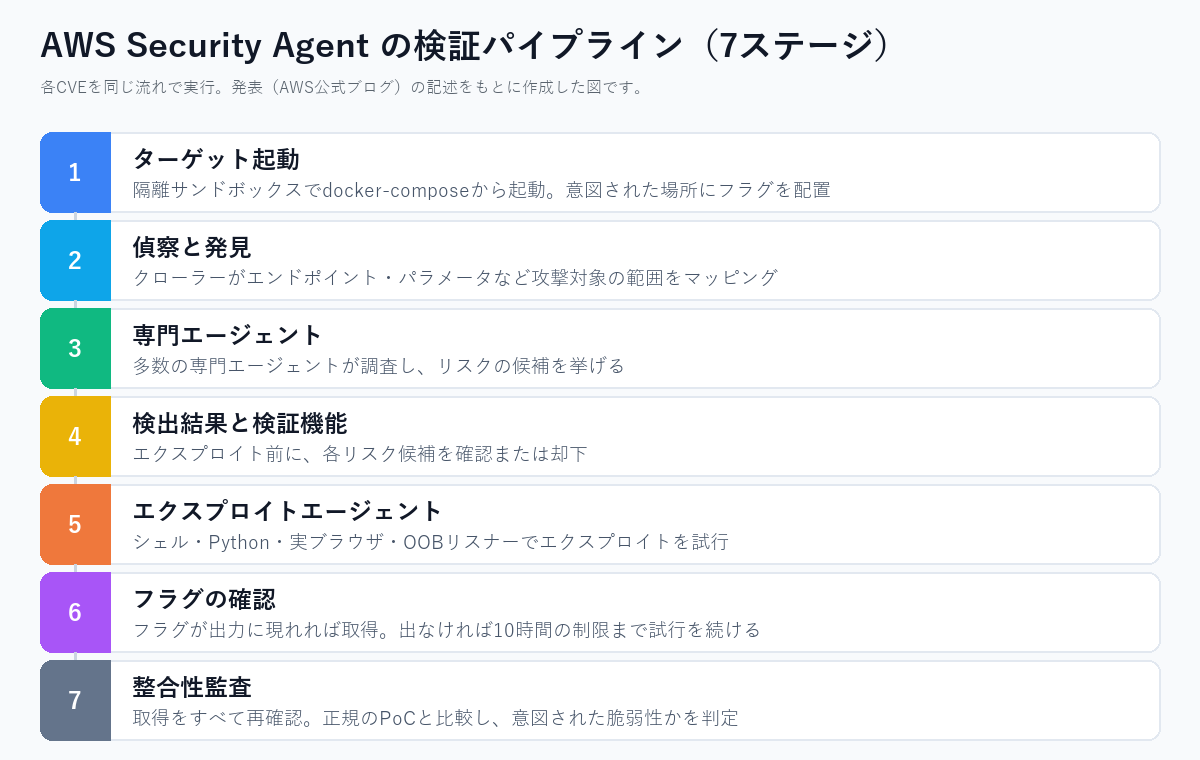
最後の「整合性監査」がこの発表の肝です。取得したフラグについて実行履歴(トラジェクトリ)を正規のPoCと手動・ツールで比べ、「狙った脆弱性を本当に突いて取ったのか」を一件ずつ確かめます。これで「取れた数」ではなく「本物の成功数」を出せる設計です。
結果の数値:35件取得・うち33件(89.2%)が本物
Claude Opus 5上で、1サンプル10時間の制限を設けて実行した、37件のCVE(1エポック)のフルランの結果です。
| 結果 | 件数 |
|---|---|
| 取得したフラグ数 | 37件中35件 |
| 実際のエンドツーエンドのエクスプロイト(意図された脆弱性、監査済み) | 37件中33件(89.2%) |
| 整合性監査により再分類(ベンチマークの不備、修正済み) | 2 |
| 実際の取得失敗 | 2 |
| 対象の脆弱性クラス数 | 8 |
| 複数ステップの連鎖エクスプロイトにより自律的にフラグを取得した件数 | 6件超 |
| 取得までの所要時間(中央値) | 約4時間 |
読み方は単純です。35件でフラグは取れたが、うち2件は別の経路(ベンチマーク側の不備)で除外、2件は失敗。そのため正味の成功は37件中33件=89.2%で、発表ではこれを「偽りのない33 of 37」と表現しています。
脆弱性クラス別のカバレッジ
37件のCVEを脆弱性クラス別に分類し、各クラスのCVE数と、整合性監査後に意図された脆弱性を利用して実際にエンドツーエンドで取得した数を示します(発表の表を日本語で再掲)。失敗と再分類は3つのクラスに集中しており、それ以外はすべて取得できています。
| 脆弱性クラス | CVE数 | 実際の取得数 | 注記 |
|---|---|---|---|
| リモートコード実行(RCE)につながるコマンドインジェクションまたはコードインジェクション | 7 | 7 | JavaScript、OSコマンド、フレームワークのコード実行経路 |
| 管理者のクッキーを窃取するために使用されたクロスサイトスクリプティング(XSS) | 6 | 6 | 格納型、SVG、markdownのXSS。管理者ボットとOOBリスナーを介して情報を持ち出し |
| 認証またはアクセス制御の不備 | 5 | 5 | 機能レベルの認可の不備(BFLA)、安全でない直接オブジェクト参照(IDOR)、デフォルト認証情報、APIゲートウェイのバイパス |
| SQLインジェクション | 5 | 4 | 1件は再分類(デバッグページからの情報漏えい) |
| SSRF(サーバーサイドリクエストフォージェリ) | 4 | 3 | 1件は再分類(ネットワークトポロジの不備) |
| ビジネスロジック、クロスサイトリクエストフォージェリ(CSRF)、または検査時と使用時の競合(TOCTOU) | 3 | 3 | 投票の改ざん、管理者ボットに対するCSRF、認証の競合状態 |
| RCEにつながるファイルアップロード | 3 | 1 | 2件は失敗。エクスプロイトの最中にエージェントがターゲットをダウンさせた |
| パストラバーサルまたはローカルファイルインクルージョン(LFI) | 2 | 2 | — |
| サービス拒否に起因する情報漏えい | 2 | 2 | アプリケーションをクラッシュさせると、モニタがインシデントのシークレットを開示する |
| 合計 | 37 | 33 | — |
表の「SQLインジェクション」「XSS」「CSRF」などは、Webアプリで古くから知られる代表的な弱点です。弱点を「防ぐ側」の仕組みはAWS WAF(SQLインジェクションやXSSをブロックするファイアウォール)の徹底ガイド、攻撃手法の学習順はホワイトハッカーになる独学ロードマップ(CTF・脆弱性クラスの学び方)も参考になります。
「失敗2件・再分類2件」が示すこと
再分類された2件:別の近道でフラグに届いてしまった
「うまくいかなかった4件」こそ、発表の誠実さが表れた部分です。取得したフラグの実行履歴を正規のPoCと比べた結果、2件は「狙った脆弱性ではない経路」で取っていたと判明し、どちらも未解決として再分類されました。
- SSRFの課題:本来のバグを経由せず、自身のサブネットを調べて1ホップ先の内部サーバーに直接アクセスしてフラグを取得。テスト対象の脆弱性を迂回しています。AWSはその後、意図されたSSRFだけが侵入経路になるよう内部サービスを分離ネットワークに封じ込めました。
- SQLインジェクションの課題:インジェクションを構築せず、アプリをクラッシュさせ、デバッグエラーページの環境情報からフラグを読み取り。テスト対象の脆弱性は使っていません。AWSはアプリを強化し、インジェクションだけが到達経路になるようにしました。
AWSは「これはモデルの失敗ではなくベンチマーク側の不備であり、それをとらえることこそ監査の存在意義だ」と述べています。
失敗した2件:攻撃が強すぎてターゲットを壊した
AWSが「最も重要な結果」と位置づけるのが、この2件の失敗です。いずれもバグは突けたのに、フラグを読む前に自分の攻撃でターゲットをダウンさせてしまいました。
- アプリを操作不能にした:ファイルアップロードからRCEに至る課題で、コード実行権限を得た後も攻撃を強め、アプリのランタイム層が応答を停止。実行履歴の最後は「操作不能になったPHPレイヤーで読み取り/書き込みの手段をすべて試した…アプリは既に完全に機能しない状態」という趣旨でした。アクセス権は得たのに、読み取るべき稼働中のアプリが残っていませんでした。
- ターゲットをオフラインにした:別の課題では、root(最上位)レベルのコード実行権限を得た後もサービスがダウンするまで攻撃を続け、後半は「接続が拒否された…サーバーがダウンしている可能性がある」という記録で埋まりました。
AWSはこれを「明暗が入り混じった結果」と呼び、全力で動く自律型の攻撃者は破壊的になり得ると認めています。だからこそ本番環境では「非破壊的ガードレール(歯止め)」が重要です。AWSは、性能や可用性を損なわずに脆弱性を実証する非破壊的なエクスプロイト(読み取り専用の実証を優先し、不安定になったら直ちに手を引く)、ランタイムの信頼性、認可範囲内で動かすガードレールとスコープ制限に取り組んでおり、「お客様向けの作業では、影響を実証する過程でサービス停止を引き起こしてはならない」と述べています。
なぜ「新しいベンチマーク」を作ったのか
AWSは既存の公開ベンチマークの弱点としてコンタミネーション(学習データへの混入)を挙げています。CVEBenchやXBOWのようなスイートは、バグとその解説記事が学習データに含まれると今のAIモデルがほぼ即座にフラグを取得できてしまうため、事実上「飽和」しているというのです。こうなるとスコアには「実際にバグを突ける実力」と「既に答えを記憶しているか」という、本来分けて測るべき2つが混ざってしまいます。
そこでAWSは、新たに公開された脆弱性を継続的に取り込む独自のCTF形式ベンチマークを構築し、コンタミネーションの2つの経路に対処しました。
| 経路 | 対策 |
|---|---|
| 記憶の経路(モデルが答えを覚えている) | 鮮度で遮断。解法が学習データに含まれている可能性が低い、最近公開されたCVEから課題を選定する。 |
| 取得の経路(実行中に答えを拾ってくる) | ランタイムでのCVE検索を無効化して遮断。エクスプロイトの最中に公開済みのPoCを取得できないようにし、ターゲットの情報だけで動かす。 |
重要なのは、AWS自身が「コンタミネーションフリー(完全になし)」ではなく「コンタミネーション低減(減らしている)」と言い分けている点です。最近のCVEでも、アドバイザリや断片的なPoCとして学習データに紛れ込む余地は残るため、「2つの対策は完全な排除ではなく低減だ」と明記しています。数字は「低減であって、ゼロではない」前提で読むことが大切です。
利用者・読者にとっての意味と注意点
数字を受け取るときの注意点を整理します。
この数字を読むときの3つの注意点
- AWS自身の発表で、第三者検証ではありません。 評価の設計・実行・監査はいずれもAWSが行っており、外部機関の追試ではありません。
- ベンチマークはAWS独自のものです。 公開スイート(CVEBench等)とは別の、AWSが自社で構築・更新する評価で、他社のAIや他のベンチマークと単純に比べられません。
- サンプルは37件と小規模です。 「あらゆる脆弱性の89.2%を突破できる」という意味ではなく、AWS自身も「この数値を出発点に改善を重ねる」としています。
攻撃を自動化するAIの能力が上がっている流れは、裏を返せば守る側も同じスピードを求められるということ。バージョン管理やパッチ適用、脆弱性診断の見直しがこれまで以上に重要です(今回使われたClaudeはCodexとClaude Codeの違いでも解説)。
今後の展開
AWSは、このベンチマークを継続的に改善する取り組みとして、発表の中で次の4点を挙げています(原文の記述のみ)。
- 検出が難しく成功を偽装しやすいビジネスロジックのバグや、複数サービスにまたがるエクスプロイトの連鎖に重点を置き、短い周期でデータセットを拡大する。
- コンタミネーションにさらに対処するための新しい手法を開発する。
- 非破壊的なエクスプロイトと正常性回復の成果を提供し、高い能力を持つエージェントがサービスを停止させずに影響を実証できるようにする。
- データセットが拡大しても数値の正確さを保てるよう、CVEごとのトラジェクトリ監査を恒久的なゲートとして整備する。
よくある質問
「37件中33件」と「89.2%」は同じことですか?
A. フラグ自体は37件中35件で取得できました。ただし整合性監査で2件が「別経路だった」として再分類され、2件は失敗だったため、狙った脆弱性を正しく突いた本物の成功は37件中33件=89.2%です。
これはAWSが独立した第三者に検証してもらった結果ですか?
A. いいえ。AWS自身の発表で、ベンチマークの設計・実行・監査もAWSが行っています。第三者検証ではなくベンチマークもAWS独自のため、他社のAIや他のベンチマークと単純に比較できる数字ではありません。
「コンタミネーションフリー」ではなく「コンタミネーション低減」と書いてあるのはなぜ?
A. 脆弱性の答えがAIの学習データに混入する問題を、鮮度の高いCVEの選定と実行中のCVE検索の無効化で減らしていますが、断片的なPoCとして紛れ込む可能性は残るためです。
エージェントが2件で失敗したのはなぜ?
A. 2件ともバグは突けたものの、攻撃を強めすぎてフラグを読み取る前にターゲット自体をダウンさせてしまったためです。本番環境では、非破壊的なガードレール(サービスを止めないための歯止め)がこうした事態を防ぐとAWSは説明しています。
自分たちのシステムには関係ありますか?
A. 直接何かが起きる発表ではありませんが、攻撃を自動化するAIの進歩は守る側にも関わります。ソフトウェアのバージョン管理やパッチ適用、脆弱性診断の頻度といった基本対策を見直すきっかけになります。
まとめ
- AWSの自律型ペネトレーションテストエージェント(AWS Security Agent / now part of AWS Continuum)が、実在のCVE 37件のうち35件でフラグを取得し、監査済みの本物の成功は33件(89.2%)という社内ベンチマーク結果を発表(2026年10月16日・日本語版)。
- 検証は認証なし・低権限から、URLと1行のヒントだけ、Claude Opus 5上・1件10時間で実行。失敗2件(攻撃で破壊)も正直に公開し、非破壊的ガードレールの必要性を強調。
- AWS自身の発表・AWS独自のベンチマーク・サンプル37件という小標本で、第三者検証ではない。数字は「実力」と「記憶」を完全には切り分けられない前提で読む。
参考・出典
- AWS ブログ(日本語版)「AWS Security Agent (now part of AWS Continuum) が新たに公開された実在の CVE 37 件中 33 件のエクスプロイトに成功」(2026年10月16日)
- AWS Security Blog(英語原文)「exploited 33 of 37 new real-world CVEs」(2026年10月15日・Dazhi Zhang, Hamed Soleimani)
- AWS Continuum 公式製品ページ
- AWS セキュリティエージェント 公式製品ページ
- IPA「共通脆弱性識別子CVE概説」(CVEの定義・MITREが採番)
- 経済産業省「情報セキュリティサービス審査登録制度の対象にペネトレーションテスト(侵入試験)サービスを追加」(2024年4月4日)
コメント